Pi 深读:一个可以被你改造成任何样子的 coding agent harness

一、为什么"harness"比模型更值得关注

过去两年,大家习惯用"模型行不行"来解释一个 coding agent 好不好用。但真正上手之后会发现:同一个模型,放进不同的 harness(智能体外壳),产出质量可以差出一个数量级。原因很简单——模型只负责"想",harness 负责决定它能看到什么(上下文怎么拼)、能做什么(工具怎么给)、做过什么(会话怎么存)、允许做到哪一步(权限与信任)。

Pi 就是在这个位置上做减法的开源实现:它不追求内置一切,而是把"可扩展"当成第一设计目标。用官方的话说——

Pi is a minimal, extensible agent harness that you can make your own.
把 Pi 改造成适配你工作流的样子,而不是让你的工作流去适配 Pi。

二、Pi 是什么

Pi 是一个跑在终端里的编码智能体:给它一个目标和一个工作目录,它会自己读文件、执行命令、修改内容、多步推进任务。它不只能写代码,也可以用来做资料整理、写作项目、数据处理。

  • 开源协议:MIT,仓库 github.com/earendil-works/pi,作者 Mario Zechner(badlogic)
  • 官网:pi.dev,包名 @earendil-works/pi-coding-agent(当前版本 1.4.x)
  • 运行环境:Node.js ≥ 22.19,macOS / Linux / Windows 均可
  • 内置工具:read(读文件)、bash(执行命令)、edit(精确编辑)、write(写文件)
  • 刻意不做的事:默认不内置 sub-agent、不内置 plan mode。Pi 的判断是——这些属于"工作流选择",应该由扩展和包来解决,而不是强塞给所有人

三、设计哲学:三个层次的自定义

Pi 把"自定义"拆成了由轻到重的三层,你可以只选最小够用的那一层:

  • 轻量层:prompt templates(可复用的提示词模板)、themes(终端配色与外观)
  • 中间层:skills(按需加载的指令包,包含脚本、参考资料、资产,遵循 Agent Skills 规范)
  • 重量层:extensions(TypeScript 模块,可以注册工具、斜杠命令、快捷键、UI、事件钩子、甚至模型 provider)

再往上还有 Pi packages:把 prompt、skill、extension、theme 打成一个包,通过 npm 或 git 分发。团队里想统一"大家都用同一套流程",打包是最省事的方式。

换句话说:想要 sub-agent?装一个包,或者让 Pi 自己给你写一个扩展。Pi 不预设你的工作流,它提供的是组装工作流的能力。

四、架构:一次请求到底发生了什么

1. Agent loop

你提交的消息被加入当前分支,Pi 用「系统提示词 + 当前分支历史 + 可用工具定义 + 技能描述」组装出模型请求,交给所选 provider。模型流式返回文本与工具调用,Pi 记录响应、逐个执行工具、记录结果,完成一轮(turn)。只要还有工具结果或排队中的消息需要模型处理,就继续下一轮,直到跑完。

2. 上下文组装

模型看到的不是"整份聊天记录",而是活动分支重建出来的历史。系统提示词来自基础指令和自动发现的上下文文件;技能只加载描述,正文按需读取;prompt template 在变成用户消息前展开;扩展也可以改写上下文或追加指令。

3. 会话是一棵树,而不是一条线

这是 Pi 比较有辨识度的设计。会话持久化为 JSONL 文件,每个 entry 都有 ID 和 parent 指针,当前 entry 决定"活动分支"。因此:

  • 回到早先某条消息继续提问,不会删掉原来的分支
  • /tree 在当前会话文件内切换分支;/fork 从某条用户消息开出独立新会话;/clone 复制当前分支
  • 离开一个分支时,Pi 可以给它生成摘要,把关键结论带到新分支,避免"重新解释一遍"

4. 上下文压缩(compaction)

接近模型上下文上限时,Pi 会自动压缩:插入一条摘要 entry 替代较早的消息,原始记录仍然保留在会话文件里。/compact 可以手动触发,还能附上"这次要保留什么"的指令。压缩失败(比如 provider 不可用)不影响手动重试。

5. 信任与权限

Pi 在加载项目级设置、技能、扩展之前会先做 project trust 决策。但要注意:project trust 只是"是否加载项目资源",它不是沙箱。工具和扩展都以 Pi 进程的操作系统权限运行,这一点在跑不可信仓库或无人值守自动化时必须自己评估。

五、五种用法,一套内核

接口 怎么用 适合场景
交互 TUI pi 日常开发、边看边改
一次性执行 pi -p "总结这个仓库" 脚本、CI、批处理
JSON 事件流 pi --mode json "..." > events.jsonl 需要结构化消费每一步事件
RPC pi --mode rpc 由外部进程/别的语言控制
TypeScript SDK 在应用内创建并控制 agent session 把 Pi 嵌进自己的产品

关键点:五种接口共用同一套 agent 与会话机制,不存在"交互模式能用、自动化模式缺功能"的割裂。这也是 Pi 能被别的应用(比如各种 GUI)接进去的基础。

六、扩展体系实操

1. Extension:一个 TypeScript 文件就是一个扩展

// ~/.pi/agent/extensions/hello.ts
import type { ExtensionAPI } from "@earendil-works/pi-coding-agent";

export default function (pi: ExtensionAPI) {
  pi.registerCommand("hello", {
    description: "Show a greeting",
    handler: async (name, ctx) => {
      ctx.ui.notify(`Hello, ${name || "world"}!`, "info");
    },
  });
}

开发期直接用 pi --extension ./hello.ts 加载即可。Pi 通过 jiti 直接跑 TypeScript,不需要单独编译;要分发就用 Pi packages 带上依赖。扩展还能注册工具、事件监听、自定义渲染、provider,甚至 MCP server。

2. Skill:给智能体的"操作手册"

pdf-tools/
├── SKILL.md
├── scripts/extract.sh
├── references/formats.md
└── assets/template.json
---
name: pdf-tools
description: Extract text and tables from PDF files. Use when reading, converting, or inspecting PDFs.
---

# PDF tools

Read `references/formats.md` before converting a document.
Run scripts relative to this skill directory.

技能遵循 Agent Skills 规范:启动时只加载 name/description,真正用到时再读正文和附属文件,避免把上下文浪费在"可能用不上"的说明上。

3. MCP:接外部工具服务

pi mcp add filesystem -- npx -y @modelcontextprotocol/server-filesystem .
pi mcp add docs --url https://example.com/mcp --bearer-token-env-var DOCS_TOKEN
pi mcp list

用户级配置在 ~/.pi/agent/mcp.json,项目级在 .pi/mcp.json(需先通过 project trust)。会话内用 /mcp 查看连接、登录、改暴露范围;外部改完配置用 /reload。

4. codemode:让模型"写脚本调工具"

开启后模型拿到一个 codemode 工具:输入是一段 JavaScript,在 QuickJS 沙箱里用 tools.xxx() 并行调用其它工具、调用分类/图像等非 LLM 模型,只有脚本的最终输出回到模型。沙箱里没有 Node API、文件系统、网络和定时器——外部世界只能通过工具访问。对"要批量处理几十个文件、又不想来回几十轮"的任务,这个设计能省大量 token 和时间。

5. Pi packages:一套配置走天下

把 prompt、skill、extension、theme 打包,pi install <source> 从 npm 或 git 安装,pi list 查看、pi update 更新。团队可以维护自己的"公司标准 agent 包"。

七、模型与凭据:不绑定任何一家

  • /login 支持浏览器 OAuth / device flow,也支持直接填 API key,凭据存在 ~/.pi/agent/auth.json
  • 也支持环境变量方式(CI 友好),以及 --api-key 临时覆盖
  • models.json 可配置自定义 provider、兼容 OpenAI/Anthropic 的端点、本地模型(llama.cpp),以及分类模型、图像模型
  • 选模型支持模糊匹配:pi --model sonnet:high,thinking 档位从 off / minimal / low / medium / high / xhigh / max

这意味着:同一套工作流可以在不同模型之间切换做对比,也可以用私有部署模型跑敏感数据——这是"harness 归你、模型也归你"的组合。

八、十分钟上手

# macOS / Linux
curl -fsSL https://pi.dev/install.sh | sh

# Windows(PowerShell)
powershell -c "irm https://pi.dev/install.ps1 | iex"

# 或者用 npm(不锁定传递依赖)
npm install -g --ignore-scripts @earendil-works/pi-coding-agent
cd /path/to/project
pi                 # 进入交互界面
/login             # 连接订阅或 API key
# 然后直接给任务,例如:把这个模块的测试补全,跑通后提交到新分支
# 会话
pi --continue      # 继续当前目录最近一次会话
pi --resume        # 打开会话选择器
# 常用斜杠命令
/session /tree /fork /clone /compact /export /share /model /mcp /reload
# 自动化
git diff | pi --print "Review this change"
pi --mode json "Inspect this repository" > events.jsonl
pi --mode rpc     # JSONL 命令走 stdin,事件走 stdout

九、Windows 桌面体验:Pi-Flash

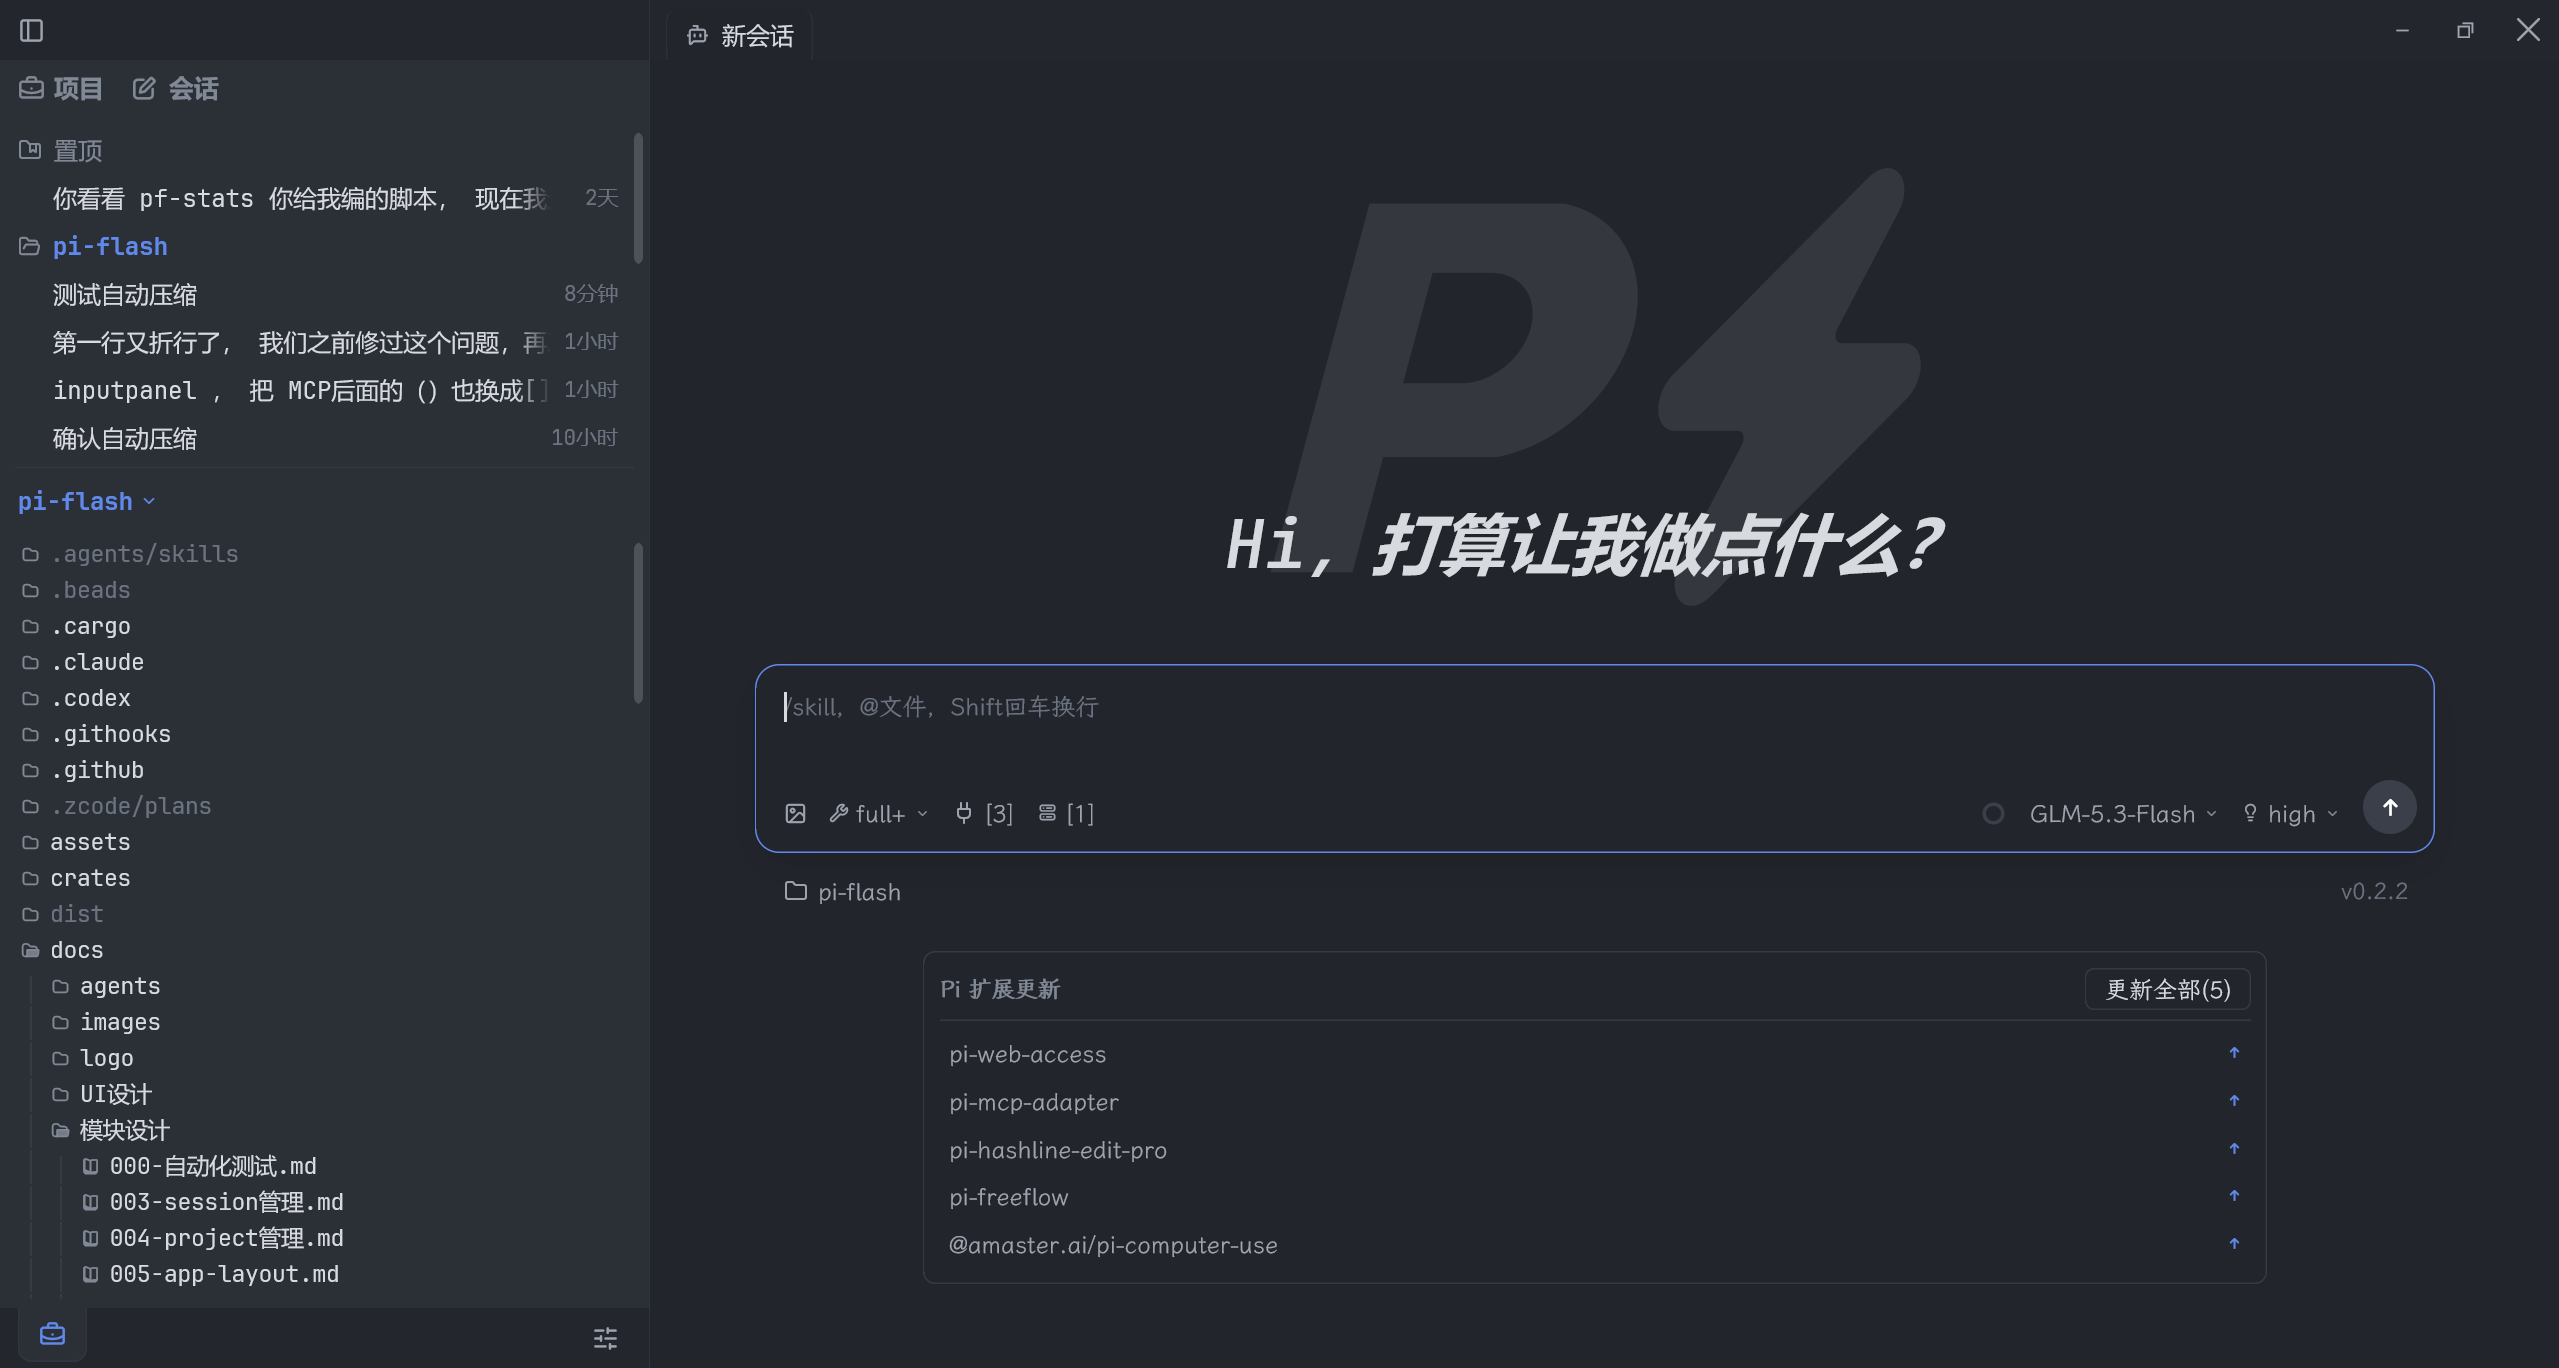
Pi 原生是终端 UI。如果希望在 Windows 上有原生桌面窗口、又不想牺牲速度,社区项目 Pi-Flash(PF) 是一个可选方案:用 Rust + GPUI 重写界面,把"快"当成第一指标(启动、首帧、输入、渲染热路径都禁止同步重活),并把 pi 直接 vendor 进安装包,通过 RPC 驱动,不依赖系统里装的 pi。

它把 Pi 的能力搬进了桌面:

  • 模型管理:设置面板内完成 provider 登录与 API key 管理(OS 凭据库加密),模型白名单与通路测试
  • 技能 / 扩展 / MCP:技能管理、扩展装载、内置扩展市场、MCP 配置
  • 会话管理:按项目分组,可恢复、重命名、置顶、删除,逾期清理,上下文用量与费用,自动/手动压缩,跨项目全量搜索
  • 消息级分支:任意一条回复上点"新分支",从该处复制出独立会话继续,原会话不动
  • 项目工具:文件树浏览编辑、文件名+全文搜索、一键在内置终端跑脚本、Git 状态与 diff
  • 内置终端:多标签(alacritty + ConPTY),与文件树、会话同窗协作
npm install -g pi-flash@latest   # 需要 Node.js ≥ 22.19
pi-flash

也可从 GitHub Releases 下载绿色包,解压双击即用(仅 Windows x64)。许可证为 GPL-3.0-or-later(继承自 Zed 项目);项目同时声明了名称与商标边界:fork 需更名并标注"基于 Pi-Flash 的非官方 fork",不得指向官方更新通道。使用和二次分发前建议读一遍它的 LICENSE 与 README。

十、把 Pi 嵌进自己的系统

Pi 的 RPC 模式是纯 stdio 上的 JSONL:外部进程写命令、读响应与事件,任何语言都能控制它。SDK 则更进一步,在 TypeScript 进程内直接创建、配置、订阅 session 事件。

一个真实例子是 DeepSeek Harness(DSH)的 pi-agent 插件:它在侧边栏放一个 π 面板,选择工作目录与模型后运行 pi,把 pi 的文本、思考、工具调用流式渲染到页面里;同时把同一能力暴露成模型工具 pi_agent(参数 prompt / cwd / model)。这说明 Pi 不只是"一个 CLI",它更像一个可被复用的 agent 运行时。

十一、适合谁,不适合谁

适合:希望把 agent 调成自己流程的开发者;需要模型自由切换或私有端点的团队;要把 agent 嵌进自己产品的工程师;喜欢终端、重视会话可回溯与可审计的人。

不适合:想要"开箱即用的全自动开发团队"(那需要自己配扩展与包);完全不想碰配置的用户;以及需要强沙箱隔离的多租户场景——Pi 的信任机制不负责隔离,这类场景要上容器化方案。

十二、和同类工具怎么选

维度 Pi 的特点
定位 极简内核 + 可扩展 harness,而不是功能全家桶
扩展性 TypeScript 扩展、技能、MCP、包分发,层次清晰
可嵌入性 交互 / print / JSON / RPC / SDK 五套接口共用内核
模型自由度 订阅、API key、兼容端点、本地模型都可以
会话模型 树状会话,分支、fork、压缩都不丢历史
上手成本 需要一点配置和习惯终端;换来的是可控性

如果你更看重"安装即用、功能覆盖广",可能倾向 Claude Code、Codex CLI 这类产品;如果你更看重"我能改、我能嵌、我能换模型",Pi 的性价比很高。两者并不冲突——Pi 的 MIT 协议和 SDK 允许你把它当成基础设施来用。

十三、安全提醒(务必读)

  • 不是沙箱:bash 工具与扩展以 Pi 进程权限运行,扩展更是直接跑在进程里。不要对不可信仓库、来源不明的扩展随意授予信任
  • 凭据保护:auth.json 里可能是 API key 或 OAuth token,注意权限,别提交进 Git
  • 导出与分享要审:/export、/share 出来的内容可能包含完整 prompt、命令输出和文件内容
  • 无人值守要收紧:CI/服务器上跑时,尽量限制工具集与目录范围,必要时用容器化方案
  • 协议边界:Pi 本体 MIT;Pi-Flash 是 GPL-3.0-or-later 的第三方桌面封装,再分发时注意许可证与名称商标约定

十四、结语

Coding agent 的竞争,正在从"模型谁更强"转向"harness 谁更懂工作流"。Pi 的选择是:内核做小,接口做全,扩展点做透,把决定权交给使用者。它不是一个替你做完所有决定的工具,而是一套让你自己组装工作流的积木——这既是它的门槛,也是它最值钱的地方。

相关链接:

Bookskill:长篇网文的工业化质量管线

Bookskill是一套完全自动化的中文小说章节生产管线。从总纲到发布HTML,一条指令跑完整个流程。56个Python引擎协同工作,覆盖章节规划、场景设计、设定校验、正文起草、112维质量审计、LLM试读、AI味精修和HTML发布八大阶段。管线内置六道质量门禁,每道门禁有明确的通过条件和失败回退策略。

管线流程总览

完整管线从前奏开始。F01手动确认项目状态——检查总纲是否更新、Truth文件是否完整、大纲是否就绪。F02将引擎更新同步到项目目录,确保管线使用最新代码。F03对当前9个Truth文件做快照保存到0_runtime/snapshots/,以章号和时间为文件名,方便将来回滚。F04确认所有前置条件满足后进入主流程。

主流程从F05开始。DirectorFlow基于总纲定位和上章回顾生成导演十要素笔记——章节定位、核心张力、场景细分、情感弧线、感官锚点、对话节拍、伏笔钩子、节奏标记、Truth调入和字数目标。每一条都从总纲和Truth自动推导,不是凭空生成的。

F06根据导演笔记和大纲生成结构化Plan。Plan包含12个字段——章节标题、章型分类、题材标签、场景数量、总字数目标、情感弧线、叙事目标清单、陷阱清单、红线清单和场景分解列表。每个场景又包含编号、地点、时间、出场角色、核心事件、字数目标、张力值等字段。

F07由Python自动将Plan中的每个场景扩展为15要素设计(见下表)。F08执行Truth预检和声纹预检——前者检查9个Truth文件的存在性和可解析性,后者对比角色对话模式与历史声纹的一致性——触发CP1门禁。F09由LLM生成正文草稿,经过CP2门禁——CJK≥5000、对话5-30%、零AI占位符。通过后Build后置钩子自动运行:获取监控引擎检查道具功法变化,时间线守护引擎检查章节时间连贯性。

F10执行11项质量核查,覆盖衔接、用词、伏笔、标题、时间、对话、悬念、世界观、声纹、画像和风格漂移,触发CP3门禁。F11驱动12组审计引擎并行扫描全文,每组10个维度通过关键词频率和正则匹配进行评分,触发CP4门禁。F12跨章宏观审计全书健康度——检查角色出场频率、情节弧线推进速度和章节节奏——触发CP5门禁。F13由LLM以专业编辑视角试读全文,从时间线、语法、逻辑、质量和建议五个维度输出分析,触发CP6门禁。F14根据试读反馈进行精修去AI味。F15生成干净HTML并同步Truth——将时间线信号、角色变化和道具变化写回Truth文件。

场景设计15要素

编号 要素 说明
1 scene_num 场景在全章中的顺序位置
2 title 一句话概括场景核心
3 function 场景在全章中的叙事功能定位
4 location 场景发生的具体空间环境
5 time_window 场景发生的具体时间和持续时长
6 characters 本场景涉及的角色清单
7 character_states 角色的初始情绪和身体状态
8 core_conflict 分表层冲突和深层冲突双层结构
9 info_reveal 分读者知/角色知/隐藏信息三层
10 emotional_arc 场景内情感的起点和终点
11 dialogue_function 对话在本场景中的叙事作用
12 sensory_anchors 覆盖五感的锚点设计
13 white_space 哪些信息留给读者自行想象
14 rhythm 场景在全章中的节奏位置
15 word_target 按场景精确分配的字数目标

Plan阶段

Plan的输入来自三个地方。总纲JSON定义了全书的卷结构——每卷包含多个阶段,每个阶段包含起止章号、阶段标题和概要。Plan阶段从总纲中解析出本章在全书的定位:"第三卷第五章,本阶段第5章共9章",这些信息注入生成的Plan供后续阶段参考。前章大纲提供叙事上下文,确保Plan的连续性。Truth文件提供九类设定数据——角色档案记录每个角色的身份背景和性格特征,世界观描述物理规则和社会结构,时间线定义每章的故事时间和关键事件,道具清单追踪重要物品的归属状态,关系网络定义角色联系类型和亲密度,情节弧线定义主要弧线和伏笔表,概念术语记录特有设定名词,科技树定义技术边界,力量体系记录修炼等级和功法。

Plan输出同时写入两个位置。outline目录下的叙事大纲JSON保持与总纲一致的格式供作者直接阅读。1_plan目录下的结构化Plan包含完整的场景分解、叙事目标和红线清单供管线解析。

场景设计阶段

场景设计引擎全自动运行。它读取Plan中的每个场景,从导演笔记中提取场景细分描述,从大纲中获取叙事上下文,然后为每个场景填充15要素——编号、标题、功能定位、空间设定、时间窗口、出场角色、角色状态、核心冲突(表层和深层双层结构)、信息揭示(读者知/角色知/隐藏三层)、情感弧线、对话功能、五感锚点、留白设计、节奏标记和字数目标。

设计完成后引擎验证两件事。第一是字数验证——根据章型计算全章最低CJK是否达标:A型每场景≥1500字,B型≥1200字,C型≥2000字,D型≥2500字。第二是字段完整性验证——检查每个场景是否缺少关键字段,如果场景缺少感知焦点或场景入口字段会输出告警。引擎不会因为字段缺失阻断管线,但会汇总所有告警供作者参考。

设定校验阶段

Validate阶段执行四项操作。Truth预检扫描9个Truth文件的存在性和可解析性——文件必须存在、JSON必须可解析、必须包含meta结构字段。Plan质量校验检查场景字段完整性和最低字数——叙事目标每条≥50字、场景弧线≥50字、感知焦点≥200字。声纹预检从Truth加载角色的历史对话模式——包括词汇习惯、句式长度、语气分布和感叹词频率——然后将正文对话与历史声纹逐角色对比。如果平时说话简短的角色突然长篇大论,引擎会输出声纹偏差告警。新角色注册扫描正文对话标签,发现Truth未记录的新角色自动生成审核diff文件供作者确认。

正文起草阶段

Draft阶段由LLM生成正文。Preflight从总纲和Plan计算本章的CJK目标字数——A型章4500-5500字、B型章4000-5000字、D型章6500-8000字。目标字数传递给LLM作为生成参数。LanguageProfile根据项目配置加载语言档案,默认中文简体。

生成的正文经过CP2门禁检查:CJK≥5000字、对话占比5%-30%(单人内心戏场景豁免)、零AI写作占位符如{TBD}或{待填}。通过后Build阶段后置钩子自动运行。获取监控引擎统计本章中道具、功法和修为的获取使用和状态变化。如果文本未体现当前恢复阶段的特征——比如角色刚苏醒但身体表现与设定不匹配——引擎输出获取异常告警。时间线守护引擎检查本章时间与前章是否连贯,是否有跳跃或回滚。Build后置钩子是阻断式的,严重异常可以选择阻断管线。

审计阶段

Review阶段驱动12组审计引擎并行扫描全文。每组从各自角度分析文本,每个维度通过关键词频率和正则匹配评分。A组分析角色对话标签密度和视角纯正度。B组检测因果词和时间词的使用一致性。C组统计悬念冲突和转折的关键词分布,评估情节推进的节奏感。D组计算视觉听觉触觉嗅觉味觉五类描写的覆盖比例,检测是否有感官被完全忽略。E组分析句式长度多样性和主语重复率。F组标记信息密度过高或过低的段落位置。

G组验证题材关键词的命中情况——仙侠章应有修炼和境界描写,都市章应有现代科技元素和历史用词。H组标记连续超长段落。I组对标网文平台内容规范进行关键词检测。J组专为穿越历史小说设计——检测秦末用词的准确性,例如嬴政不会用秒做时间单位、不会用心理防线这种现代心理学词汇。古今词汇同时出现是情节需要而不是漏洞。K组扫描AI高频套路词和句式模板。L组将正文中的角色行为世界观描述和道具使用与Truth文件逐条对比,标注所有不匹配之处。

审计完成后触发CP4门禁。112维综合评分按章节类型选择阈值——A型800分、B型840分、C型878分、D型920分。3次自动重审后差距≤5%时自动旁路防止无限循环。伏笔检测引擎在同一阶段跨章扫描所有未揭示伏笔——统计每个伏笔的种植位置、最后提及位置和间隔章数。遗失超过2条阻断管线。评审器引擎输出6维结构化反馈——对话流畅度、节奏把控、描写密度、语言质量、设定一致性和整体张力——每条反馈包含问题段落的具体位置和修复建议。

LLM试读阶段

Readthrough阶段触发CP6门禁。LLM以专业编辑视角阅读全文,从五个维度输出分析结果。时间线维度检查章节间的时间连贯性,指出矛盾段落的具体位置。语法维度检查语病和重复用词,每条给出修改建议。逻辑维度检查角色行为的合理性和对话的自然度。质量维度对文笔节奏和情感张力做综合评分。建议维度按优先级列出改进点——高优先级必须修复,中优先级建议修复,低优先级可选优化。

精修阶段

Polish引擎根据LLM试读反馈进行L2自动精修。五个等级逐级深入:L1替换禁用词、L2修复AI句式模板、L3调整句式长短节奏、L4优化被动语态、L5处理叙事距离异常。合计处理40多种AI写作模式,精修完成后输出改动对比摘要。

发布阶段

Release阶段生成干净的HTML文件——纯文本章节,不包含审计分数或技术元数据。引擎同时刷新阅读器首页并执行Truth同步,将时间线信号和角色变化写回Truth文件。

循环工程与逃逸策略

每阶段的失败重试次数有限制——Plan和Draft最多重试3次,Review最多3次,Release最多1次。超过重试次数后触发逃逸策略:Plan阶段简化结构重新提交,Draft阶段降低字数目标重新生成,Review阶段自动精修后重新审计,Release阶段条件精修后直接发布。失败的详细日志全部保留供回溯。

Truth快照与回滚

每章通过F08后管线自动对9个Truth文件做快照,保存在0_runtime/snapshots/下,以章号和时间为文件名。如果后续发现Truth被误修改可以从快照恢复。管线最多保留50个快照,超过后自动覆盖最旧的。快照文件包含完整的角色档案、世界观设定、时间线、道具清单、关系网络、情节弧线、概念术语、科技树和力量体系——全部9个文件在同一时间点的完整副本。

导航推荐与进度追踪

Navigator引擎在每阶段完成后推荐下一步操作——Plan完成后推荐SceneDesign,通过后推荐Validate,以此类推。如果有未通过的门禁,优先建议回到失败的阶段。进度追踪系统通过PROGRESS.md维护全章节完成状态表格,每次状态更新时重新计算全书完成度百分比。表格包含15列对应F01到F15的完成标记。

词汇进化追踪

词汇进化追踪系统专为穿越小说设计——记录主角每章学会的现代词汇,从第一章的零基础到后期逐渐掌握现代用语。系统追踪每个词汇的添加时间和使用频率,确保角色的语言能力呈渐进曲线变化而非跳跃式发展。这个系统与审计引擎的J组联动——如果角色在早期章节使用了尚未学会的现代词汇,审计会检测到时代错位标记并扣分。例如嬴政在第一周不可能知道"手机"这个词,如果正文中出现会被标记为时代错位。词汇进化表同时提供给LLM作为Draft生成的上下文参考,确保正文中角色使用的词汇与其当前的语言能力匹配。

风格漂移检测与声纹维护

风格漂移引擎在每次Review阶段运行,对比当前章节与历史章节在句式长度分布、词汇难度曲线、对话比例和叙事距离等维度上的差异。如果某个维度的偏差超过阈值——比如本章句式突然变长或对话比例骤降——引擎输出风格漂移告警。声纹维护系统记录每个角色在每章的对话特征——用词习惯、平均句长、语气词频率和感叹号使用密度。跨章对比时如果某个角色的声纹特征发生跳变,告警触发。

情节漏洞检测与关系图谱

PlotHole检测引擎在宏观审计阶段运行,扫描全书的因果链断裂、角色动机缺失和时间线矛盾。检测结果汇总到plot_holes.json供作者审阅。关系图谱引擎从Truth中的关系网络和正文中的角色互动频率生成角色关系图以Markdown格式保存,每章更新。图谱显示角色之间的联系强度、互动频率和关系类型变化——敌对变为合作或陌生变为亲近都会在图谱中呈现。关系图谱同时作为宏观审计的输入,如果某个核心角色在多章未出现或与设定的关系网络不一致,审计会标记。

MoA多视角评估模式

MoA引擎提供三种评估视角用于深度分析管线本身的质量。代码质量视角扫描引擎代码中的潜在bug、死代码和反模式。功能差距视角将引擎功能与同类工具对比。测试文档视角评估测试覆盖率和文档完整度。三种视角汇总成MoA报告,供开发者在迭代计划中参考。

CLI命令与配置系统

Bookskill通过pip安装后提供bookskill命令行工具。plan、draft、review、release、run-all等子命令覆盖全部管线阶段,每个命令接受--project参数指定项目目录。配置系统通过config/pipeline.yaml集中管理——包含全序列定义、门禁阈值、重试限制、逃逸策略和进度表头。管线启动时自动加载配置并将其缓存到运行时状态。prompt-cache系统对LLM阶段的输入进行哈希比较,如果上下文中Plan和Truth内容与上次生成相比没有变化,直接复用缓存的LLM生成结果,减少token消耗。

管线状态持久化到项目目录下的.pipeline5_state.json文件,包含当前章节号、已完成阶段列表和失败门禁记录。每次阶段完成时自动更新状态文件,中断后重新运行时自动从断点继续而非从头开始。进度追踪通过PROGRESS.md以表格形式可视化,每章每阶段用X标记完成情况,一目了然。

测试体系与基准

管线内置519个测试,覆盖审计引擎、验证器、评审器、门禁系统、精修引擎和发布引擎的全部核心路径。测试运行时间约12秒。benchmark覆盖9种不同规模的文本处理场景——从短文本审计到长文本精修。测试使用任务级隔离,每个测试在临时目录中运行,不接触真实项目数据。门禁测试验证六个CP门禁的阻断和旁路逻辑,精修测试验证五个等级各自处理的AI模式类型。测试产出覆盖率报告和性能基准数据,每次更新后自动对比基准线,性能退化超过阈值会告警。

生命周期引擎

管线配套了完整的生命周期引擎,覆盖Build、Verify、Review和Ship四个阶段。Build阶段在F09完成后运行获取监控引擎和时间线守护引擎——前者追踪道具功法和修为的状态机变化,后者检查时间跳跃和总纲合规。Verify阶段运行验证器引擎组的10项检查——CJK字数、对话质量、场景完整性、钩子密度、占位符残留、主语一致性、段落结构、文件名规范、JSON有效性和禁用词。Review阶段运行6维评审器——对话流、节奏、描写、语言、设定和张力——每条评审输出问题段落的具体位置和修复建议。Ship阶段执行版本号更新和发布公告生成。

六道门禁

Gate 触发 条件 失败回退
CP1 F08_Validate 9个truth文件完整可解析+Plan字段达标 退回F06
CP2 F09_Draft CJK≥5000+对话5-30%+零AI占位符 重写Draft
CP3 F10_QC 11项QC全部PASS 修复后重跑QC
CP4 F11_Review 112维评分≥阈值(A800/B840/C878/D920) 退回Draft
CP5 F12_MacroAudit 宏观健康≥600/1000 跨章修复
CP6 F13_Readthrough LLM试读无高危问题 修复后重试读

15-Flow输入输出表

Flow 名称 类型 读入 输出 门禁
F01 前置确认 手动 — — —
F02 同步skill 手动 master skill/ — —
F03 快照truth 自动 truth/9文件 0_runtime/snapshots/ —
F04 就绪 手动 1_plan/, 3_draft/ — —
F05 导演笔记 LLM 大纲, truth_timeline 0_runtime/chXX_director_notes.json —
F06 章节规划 LLM 总纲+大纲+truth_chars/world/timeline/plot 1_plan/chXX_plan.json —
F07 场景设计 Python director_notes+plan+大纲 2_scene_design/chXX_scene_design.json —
F08 设定校验 Python plan.json+truth全部 2_validation/chXX_validation.json CP1
F09 正文草稿 LLM plan+scene_design+director_notes+truth 3_draft/chXX_draft.json CP2
F10 质量核查 Python draft+truth全部 0_runtime/qc_chXX.json CP3
F11 112维审计 Python draft+plan+truth全部 4_review/chXX_review.json CP4
F12 宏观审计 Python truth+历史review 0_runtime/cp6_report.json CP5
F13 LLM试读 LLM/Python draft+truth_chars/world/timeline 0_runtime/chXX_readthrough.json CP6
F14 精修润色 Python draft+readthrough+de-ai规则 4_polish/chXX_polish.json —
F15 发布 Python polish或draft+review+truth+css 5_release/chXX_release.html —

Truth文件索引

文件 内容 读取Flow
truth_characters 角色身份/性格/声纹 F06 F07 F08 F09 F11 F13
truth_world 世界观/时空规则 F06 F08 F09 F11 F13
truth_timeline 每章时间锚点 F05 F06 F08 F11 F13
truth_plot 情节弧线/伏笔 F06 F08 F11
truth_props 道具归属/状态 F07 F08 F11
truth_relationships 角色关系网络 F08 F11
truth_concepts 概念术语 F08 F11
truth_tech 科技树 F08 F11
truth_power 力量体系 F08 F11

安装

Bookskill支持pip安装和npm快捷命令。安装后通过bookskill命令行操作:bookskill run-all ch01 --project /path 一条指令跑完整管线。管线内置519个测试,运行时间约12秒。项目初始化只需要创建truth/目录并放入9个设定文件,然后运行truth-check命令验证完整性即可开始管线。

开始新章节只需一条命令:bookskill run-all ch01 --project /my/novel。管线会自动发现总纲文件和大纲目录,从总纲中解析章节定位,加载Truth文件,然后按F01到F15的顺序逐个执行。如果某个门禁失败管线会自动回退到前一阶段,修复问题后重新执行即可。

Bookskill适用于任何长篇网文项目——仙侠、都市、历史、奇幻、科幻均可。管线不依赖特定的题材设定,所有题材相关的检测通过J组和G组的可配置关键词列表完成。更换项目时只需要修改总纲和Truth文件,引擎代码无需任何改动。56个引擎、112维审计、6道门禁、5级精修——这些数字背后是一个简单的信念:好的故事不应该被糟糕的流程管理拖累。让引擎处理一致性,让作者专注于创作本身。当你不用再担心伏笔遗忘、时间线矛盾、角色跑偏和AI痕迹的时候,写作速度自然就提上去了——不是因为你写快了,是因为你不用停下来查设定、翻前文和反复修改了。这就是工业化的意义所在。